Criador do OpenClaw diz ter consumido US$ 10 milhões em tokens de IA em um mês
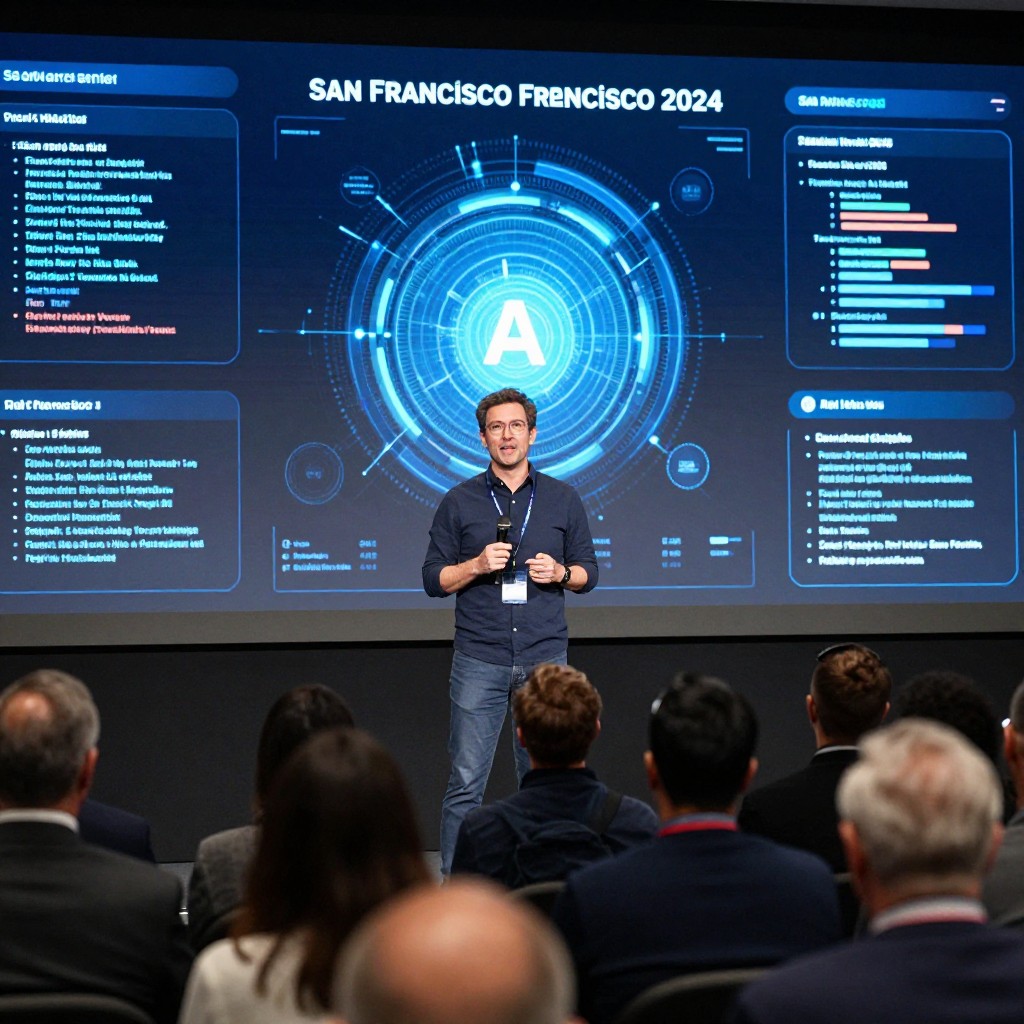
Peter Steinberger, criador do OpenClaw e integrante da equipe técnica da OpenAI, afirmou ter usado cerca de US$ 10 milhões em tokens de inteligência artificial ao longo de setembro de 2026. A estimativa foi apresentada em 21 de outubro, durante a conferência Cloudflare Connect 2026, em São Francisco, nos Estados Unidos.
O montante, segundo Steinberger, corresponde aos custos de processamento de cargas de trabalho de IA financiadas por investidores – não a uma despesa pessoal. A declaração ocorreu em uma conversa com Dane Knecht, diretor de tecnologia da Cloudflare, e surpreendeu parte dos participantes pelo tamanho do valor.
Knecht observou que Steinberger já havia mencionado contar com um orçamento praticamente ilimitado para consumir tokens, condição incomum para a maioria dos desenvolvedores e das empresas. O criador do OpenClaw ponderou, porém, que um volume tão alto de processamento nem sempre se traduz em resultados úteis.
O episódio evidencia um dos obstáculos à expansão de agentes autônomos: o custo de mantê-los operando. Esses sistemas podem fazer chamadas repetidas a modelos de linguagem para interpretar instruções, planejar etapas e executar tarefas. Quanto mais longa e complexa a atividade, maior pode ser o consumo de tokens e, consequentemente, a conta.
Infraestrutura, custos e execução na nuvem
Na conferência, Steinberger avaliou que a infraestrutura ainda não acompanhou por completo o avanço dos agentes inteligentes. Na visão dele, muitas dessas operações deveriam acontecer na nuvem, em vez de depender dos computadores pessoais dos usuários.
A migração, no entanto, não elimina os desafios. Serviços em nuvem podem exigir gastos contínuos com processamento e armazenamento, além de cuidados específicos com privacidade e cumprimento de normas. Organizações que adotam agentes precisam avaliar não só o preço de cada interação, mas também o efeito do uso recorrente em escala.
Uma forma de tornar os custos mais previsíveis é definir limites de consumo e acompanhar quais tarefas geram maior volume de processamento. Também pode ser útil reservar modelos mais potentes para decisões complexas e recorrer a opções mais econômicas em atividades rotineiras. Assim, a autonomia do sistema não precisa significar uso irrestrito de recursos.
Contribuições de IA e revisão de código
Outro tema discutido foi a influência da inteligência artificial no desenvolvimento de software de código aberto. Dane Knecht levantou a preocupação de que a quantidade crescente de código produzido com auxílio de IA possa aumentar o volume de contribuições de baixa qualidade recebidas por quem mantém projetos.
Steinberger argumentou que o processo de revisão precisa se adaptar. Para facilitar a avaliação, quem propõe uma alteração deveria apresentar não apenas o código pronto, mas também informações sobre o problema enfrentado, as escolhas feitas e o caminho que levou à solução. Essa documentação pode ajudar revisores a entender a proposta e identificar falhas com mais rapidez.
A recomendação é relevante mesmo quando o código parece funcionar: uma alteração pode introduzir vulnerabilidades, dificultar futuras manutenções ou resolver apenas parcialmente o problema. Explicar o raciocínio por trás da implementação permite avaliar melhor seus efeitos e aumenta a confiança no processo de revisão.
Agentes mais presentes e permissões controladas
Questionado sobre a possibilidade de cada pessoa usar centenas de agentes nos próximos anos, Steinberger demonstrou ceticismo. Em vez de imaginar um grande número de assistentes separados, ele considera mais provável que as pessoas contem com sistemas capazes de acompanhar suas atividades, prestar ajuda contínua e antecipar necessidades antes de receber uma solicitação explícita.
Esse cenário pressupõe agentes com maior autonomia para realizar tarefas e tomar decisões, reduzindo a necessidade de instruções constantes. Mas quanto maior a capacidade de agir sem supervisão imediata, mais importante se torna limitar o que cada sistema pode acessar e modificar.
O acesso a dados sensíveis e recursos corporativos foi apontado como uma fonte importante de risco. Steinberger afirmou que a confiança depende tanto da qualidade dos modelos quanto dos mecanismos de controle instalados ao redor deles. Melhorias recentes nos modelos, segundo ele, permitiram rever decisões técnicas adotadas nas primeiras versões do OpenClaw.
Ainda assim, avanços na mitigação de ataques de prompt injection não tornam seguro conceder permissões irrestritas. Um agente com acesso amplo pode interpretar instruções de maneira inadequada ou executar ações indesejadas. Por isso, permissões mínimas, registros de atividade e aprovação humana para operações críticas são medidas importantes para reduzir a exposição.
Um agente para supervisionar outro
Entre as alternativas discutidas por Steinberger está o uso de um segundo agente para avaliar e autorizar ações solicitadas pelo primeiro. Nesse arranjo, o sistema encarregado de executar uma tarefa precisaria justificar determinadas permissões a outro agente, que analisaria se elas são necessárias ou se há uma forma mais segura de concluir o trabalho.
A interação também poderia levar os sistemas a reconsiderar decisões e buscar opções compatíveis com os limites definidos. Ainda assim, esse tipo de supervisão não elimina a necessidade de controles externos: a eficácia depende da confiabilidade dos modelos e da clareza das regras estabelecidas.
Para empresas que avaliam adotar agentes, a discussão aponta para uma implantação gradual. Começar com tarefas de baixo risco, restringir o acesso a arquivos e serviços e exigir confirmação antes de ações irreversíveis ajuda a identificar problemas sem expor sistemas importantes. O acompanhamento regular dos custos e das decisões tomadas pelos agentes também permite ajustar limites e detectar comportamentos inesperados.
O gasto relatado por Steinberger não representa necessariamente o custo típico de usar inteligência artificial. Ainda assim, mostra como a conta pode crescer quando agentes executam muitas tarefas e recorrem repetidamente a modelos. A expansão dessa tecnologia dependerá, portanto, não apenas de modelos mais capazes, mas também de infraestrutura eficiente, controle de despesas e mecanismos sólidos de segurança.